RTX3090を二枚刺ししたら両方Code 43になった——原因はチップセット側のPCIeスロットだった
この記事は、筆者のWindowsマルチGPU環境で実際に起きた問題を、AIとの調査ログをもとに整理したものです。 具体的なマシン名、ユーザー名、IPアドレス、ローカルパスなどの環境固有情報は省略・一般化しています。 すべての環境で同じ結果になるとは限りませんが、Windows 11、NVIDIA GPU、マルチGPU構成、ローカルLLMを使っている人の切り分け材料になれば幸いです。
起きたこと
ローカルLLM用のサブ機に、中古で買い足したRTX 3090を追加しました。もともと1枚RTX 3090が入っていたので、これで24GB×2の48GB構成になるはずでした。
ところが換装した瞬間から、2枚とも動かなくなりました。デバイスマネージャーで両方ともCode 43です。
構成はこうです。
- Windows 11 Pro
- MSI MEG X570 UNIFY / Ryzen 9 5950X / 128GB
- GPU 1枚目: RTX 3090(CPU直結のPCIe x8スロット)
- GPU 2枚目: RTX 3090(チップセット経由のPCIe x4スロット)
- 2枚目は表示出力なしのヘッドレス
- ローカルLLM実行環境: LM Studio
ここで大事な前提があります。この構成は、2枚目がRTX 3080だったときには、同じスロット配置で数年間まったく問題なく動いていました。 変えたのは2枚目のカードだけです。スロットもケーブルも電源も、そのままです。
また、買い足した中古のRTX 3090は、別のマシンに単体で挿して事前に検品してありました。VRAM全域テスト、OCCTの3D負荷1時間、Blenderでの数時間のレンダリング、全出力端子の確認まで通っています。単体では完全に健全なカードです。
症状の詳細
症状には、いくつか奇妙な特徴がありました。
ブートすると必ず2枚とも落ちます。 コールドブートでもウォームリブートでも同じで、しかもWindowsのイベントログには何も残りません。エラーひとつ出ないまま、デバイスマネージャーだけが両方Code 43になっています。
起動後に1枚ずつ、時間を空けて初期化し直すと、確率的に成功します。 デバイスを削除してハードウェアの再スキャンをかける操作を、1枚ずつ60秒以上の間隔を空けて実行すると、体感で3〜5割くらいの確率で両方とも「正常」になりました。同時にやると必ず失敗します。
そして「正常」になっても、計算はできませんでした。
デバイスマネージャーが正常(Code
0)で画面も出ているのに、nvidia-smi
は次のように失敗します。
Failed to initialize NVML: Unknown ErrorCUDAの初期化も通りません。cuInit() は
CUDA_ERROR_NO_DEVICE(エラーコード100)を返してきます。つまり表示系だけ生きていて、計算系は完全に死んでいる状態です。
おもしろいことに、両カードのHDMIオーディオ機能だけは、2枚同時でも常に正常に動いていました。 PCIeのバスとしては2枚とも見えていて、動かないのはGPU本体の初期化だけ、ということです。
唯一の物証はdxgkrnlのライブダンプだった
イベントログが無言なので、証拠がありません。唯一見つかったのが、Windowsが密かに保存していたライブダンプでした。
置き場所はここです。
C:\Windows\LiveKernelReports\
C:\ProgramData\Microsoft\Windows\WER\ReportQueue\
これをWinDbgで開くと、次の内容でした。
VIDEO_MINIPORT_FAILED_LIVEDUMP (0x1B0)
Arg1: 0x00000002       Start device failed
Arg2: 0xC000009A       STATUS_INSUFFICIENT_RESOURCES

stack:
dxgkrnl!DpiFdoStartAdapterThread
dxgkrnl!DpiLdaStartAdapterInChain
dxgkrnl!DpiFdoStartAdapter
読み解くと「グラフィックスドライバがアダプタの起動中にリソース確保に失敗し、自分から降りた」という意味になります。電源が落ちたわけでも、PCIeのリンクエラーが出たわけでもありません。実際、この期間中のWHEA(ハードウェアエラー)の記録はゼロでした。
STATUS_INSUFFICIENT_RESOURCES
という名前から、つい「メモリが足りない」「BARが足りない」と考えたくなりますが、これはNTSTATUSとしてはかなり汎用的なコードです。ドライバ内部のどこかで必要な資源を確保できなかった、という以上のことは分かりません。
効かなかったものの一覧
ここからは消去法でした。丸一日かけて、思いつく限りのソフトウェア側の変数を潰しました。結果は次のとおりです。
| 試したこと | 内容 | 結果 |
|---|---|---|
| ドライバ世代 | 552.44 / 566.36 / 610.47 / 610.88 をそれぞれクリーンインストール | 変わらず |
| Windows更新 | 正常な別マシンと同じビルドまで更新 | 変わらず |
| BIOS更新 | AGESA 1.2.0.E → 1.2.0.F | 変わらず |
| BIOS設定 | 全初期化、SR-IOV無効、Data Link Feature Exchange無効、XMP無効、PBO無効 | 変わらず |
| メモリ整合性(HVCI) | 完全に停止して再起動 | 変わらず |
| ブートの種類 | コールドブート / ウォームリブート | 変わらず |
| モニターの接続先 | どちらのカードに挿しても | 変わらず |
| 2枚目の無効化 | デバイスマネージャーで無効にしても、物理的に挿さっているだけで1枚目のブート初期化が失敗 | 変わらず |
| 割り込みとリソース | MSI割り込み正常、BARと親ブリッジの窓を全段実測して正常を確認 | 割当は正しいのに失敗 |
ドライバの世代で唯一違ったのは、壊れ方の行儀だけでした。
- 552.44(R550系):
片方の失敗がもう片方を巻き込まない。時間差で初期化すれば2枚とも「正常」になり得る(ただし計算は死んだまま) - 566.36 / 610.x系:
2枚目の初期化失敗が、正常に動いている1枚目まで道連れにして落とす - 576.80: この失敗でブートごとハングする(いちばん行儀が悪い)
新しいドライバほど「中途半端な状態を許さない」設計になっているように見えました。どれも問題そのものは直しません。
解決したのは物理配置の変更だった
結論から言うと、2枚とも CPU直結のスロットに並べ替えたら、それだけで全部直りました。
このマザーボードには、CPU直結のx16スロットが2本(2枚挿すとx8/x8に分かれる)と、チップセット経由のスロットがあります。もともと2枚目はチップセット側に挿さっていました。これを、CPU直結の2本に並べ替えたわけです。
問題は、CPU直結の2本目には10GbEのネットワークカードが挿さっていたことでした。そこで、そのNICを撤去してオンボードの2.5GbEに降りる、という妥協をしています。
結果は劇的でした。
- ブート直後から2枚ともCode 0
nvidia-smiが2枚を正常に列挙cuInit()が成功し、CUDAデバイスが2個見える- 37GB級のLLMが2枚に分割してロードできた
同じドライバ、同じBIOS、同じOS、同じカード、同じ電源です。GPUについて変えたのは、挿す場所だけでした。
なぜチップセット側のスロットだと動かなかったのか
ここは推測を含みます。確実に言えるのは「この構成では動かず、CPU直結にしたら動いた」という事実だけで、原因そのものを実測で確定したわけではありません。
そのうえで、筆者の理解はこうです。
チップセット配下のPCIeスロットは、電気的にPCIeの信号が来ているだけで、CPU直結のスロットとは性質が違います。CPUとの間にチップセットという中継が1段入り、その先の帯域はNVMe SSDやUSB、SATAなど他のデバイスと共有されます。レイテンシもトポロジも、ファームウェアから見た扱いも別物です。「挿さって認識するから同じ」ではありません。
そして今回の決定的な違いは、2枚が同じ型番(同じPCIデバイスID)のGPUになったことでした。異なるカード(3090と3080)の組み合わせでは、ドライバは2枚を独立した別物として初期化していたのだと思います。ところが同一デバイスIDのGPUが2枚見えると、ドライバはマルチGPUとしてまとめて扱う経路に入ります。そこで、CPU直結とチップセット経由という非対称なトポロジが問題になったのではないか、という見立てです。
傍証として、世の中で「RTX 3090を2枚で動かしている」構成は、ほぼ例外なくCPU直結のx8/x8です。コミュニティを調べても、チップセット側に2枚目を挿した構成では、Code 43になる報告や、動いたとしても長いコンテキストで出力が壊れるという報告(llama.cppのissue)が見つかりました。
一方で、Linuxでは同じようなチップセット配下の構成が動いている報告もあります。つまりこれはWindowsのドライバ固有の相性という面もありそうです。ただし「OSを選べば動く」を前提にした構成は、あまり安全な賭けではないと思います。
物理的な落とし穴:スロットの間隔
CPU直結の2本に並べる、と言葉にするのは簡単ですが、ここにも罠がありました。
このマザーボードのCPU直結スロットは、**3スロット間隔(60.96mm)**で配置されています。2019年の設計で、当時の2スロット厚のカードを2枚並べる前提です。
ところが載せようとしたカードの厚みは、片方が61mm(3.002スロット)、もう片方が57mmでした。厚い方を上に置くと、計算上の隙間はマイナスになります。つまり物理的に当たります。
薄い57mmのカードを上にすると、下のカードのバックプレートまで数mmの隙間ができます。今回はこの順序で、ファンが干渉しないことを確認したうえで組みました。実際に測ってみるまでは「どちらの順でも入るだろう」と思っていたので、これは事前に計算しておくべきでした。
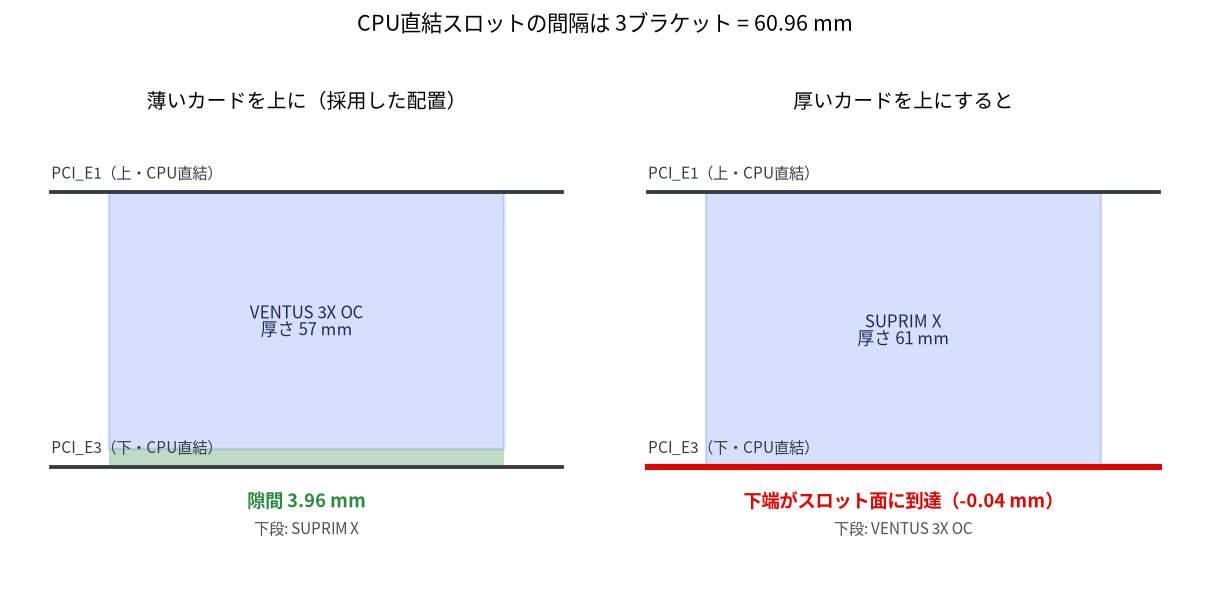
スロットの間隔は「ブラケット1枚が20.32mm」で計算できます。手持ちのカードの公称寸法(メーカーのスペック表に厚みがmmで載っています)と突き合わせれば、挿す前に判断できます。
当然、この配置では上のカードの吸気がかなり苦しくなります。そこで電力制限を掛けました。全負荷で40分ほど回したところ、上のカードはファン98%で84〜85℃の平衡に落ち着きました。余裕があるとは言えませんが、実用範囲には収まっています。
同じ症状のときの確認手順
同じように「GPUを増やしたら動かなくなった」という場合、次の順で見ると切り分けが早いと思います。
1. デバイスマネージャーの「正常」を信じない
Code 0は「表示ドライバが起動した」以上の意味を持ちません。計算まで生きているかは、別に確かめる必要があります。
nvidia-smiこれで全部のカードが列挙されるか。さらに確実なのは、CUDAの初期化そのものを叩いてみることです。CUDA
Toolkitを入れなくても、ドライバに含まれる nvcuda.dll
を直接呼べば確認できます。
$src = @'
using System;
using System.Runtime.InteropServices;
public static class Cuda {
    [DllImport("nvcuda.dll")] public static extern int cuInit(uint flags);
    [DllImport("nvcuda.dll")] public static extern int cuDeviceGetCount(out int count);
}
'@
Add-Type -TypeDefinition $src
$rc = [Cuda]::cuInit(0)
$n = 0
[Cuda]::cuDeviceGetCount([ref]$n) | Out-Null
"cuInit=$rc devices=$n"
cuInit=0
で、デバイス数が実際の枚数と一致していれば本物です。
2. BARとブリッジの窓の割当を実測する
「Resizable BARを有効にしたから大丈夫」ではなく、割り当てられた結果を見ます。
pnputil /enum-devices /class Display /resourcesこれで各カードのメモリ窓が見えます。24GBクラスのカードなら、16MB程度の小さい窓と、256MB(ReBAR有効なら数GB〜数十GB)の大きな窓が並ぶはずです。大きい窓が割り当てられていないカードは、そこで既に詰んでいます。
実は今回、最初にぶつかったのはこれとは別の問題でした。Resizable BARを有効にしていると、このマザーボードのファームウェアがチップセット側のブリッジに17〜24MBしかアドレス窓を用意せず(必要なのは300MB以上)、2枚目の大きなBARが割り当てられないままになっていたのです。Resizable BARを無効にしてAbove 4G Decodingだけ有効にしたら、両方に正しく割り当たりました。
3. ライブダンプを探す
イベントログが無言でも、グラフィックスカーネルがダンプを残していることがあります。
C:\Windows\LiveKernelReports\
C:\ProgramData\Microsoft\Windows\WER\ReportQueue\
0x1B0 の Arg1=2 は「Start device
failed」、Arg2
がドライバの返したNTSTATUSです。ここまで分かると、電源やケーブルを疑う段階は終わります。
4. 1枚ずつ時間差で初期化してみる
pnputil /remove-device "<インスタンスID>"
pnputil /scan-devices
1枚だけ再初期化して、60秒ほど待ってからもう1枚。これで通るなら、同時初期化の競合という線が濃くなります。ただし今回のように、通っても計算が死んでいる場合があるので、必ず手順1まで確認してください。
5. CPU直結スロットに移せるか検討する
ここまでで直らなければ、トポロジを疑う番です。マザーボードのマニュアルで、どのスロットがCPU直結で、どのスロットがチップセット経由かを確認します。仕様表には「x16/x8+x8(CPU)」「x4(チップセット)」のように書かれています。
移す前に、前の章で書いたスロット間隔とカード厚の計算をしておくことをおすすめします。
まとめ
今回の結論はこうです。
カードも電源もドライバも悪くありませんでした。同じ型番のGPUを2枚使うとき、片方をチップセット経由のスロットに挿していたことが問題でした。
ソフトウェア側で丸一日かけて潰した変数——ドライバ4世代、OS更新、BIOS更新、BIOS設定の全初期化、メモリ整合性——は、どれひとつとして症状を変えませんでした。結果として、それらの作業は「ソフトウェアでは直らない」ことを確かめるための消去法になりました。
マルチGPUを組むときは、挿す場所をカードの選定と同じくらい真剣に考える価値があります。特に同じ型番を並べる場合は、CPU直結のレーンに対称に置ける構成を最初から選んだほうが安全です。
最後に、ひとつ注意を書いておきます。この記事で解決したのは、あくまでGPUの初期化が失敗する問題です。このマシンには組み立て当初から続く別の不安定さ(重い処理中の突然の再起動など)があり、そちらはこの変更とは無関係に残りました。ひとつの症状が直ったことを、マシン全体が健康になった証拠と混同しないようにしています。
コメント